Vyrovnávací paměti přepínače jsou malé oblasti paměti uvnitř síťového přepínače, které udržují pakety na okamžik, kdy provoz přichází rychleji, než jej port dokáže odeslat. Na tiché podnikové LAN to zní jako poznámka pod čarou. Uvnitř tréninkového clusteru AI nebo husté cloudové struktury může stejných pár megabajtů paměti rozhodnout, zda distribuovaná úloha skončí včas, nebo se zastaví čekání na jediném přetíženém spoji.
Základní myšlenka je jednoduchá, ale podkopává spoustu nákupních rozhodnutí: nárazníky jsou cenné, protože pohlcují výbuchy, přestovíce bufferu není automaticky lepší. Správný návrh závisí na vašem vzoru provozu, na tom, jak citlivá je pracovní zátěž na latenci nebo ztrátu, jakou metodu řízení zahlcení-používáte a jak přepínač šíří vyrovnávací paměť mezi porty a fronty. Přepínač s velmi velkou vyrovnávací pamětí může stále fungovat hůře než menší, pokud tato paměť skrývá zahlcení místo toho, aby ji vyčerpala.
Tato příručka je napsána na základě vzorů, které se běžně vyskytují u tkanin RoCEv2 a nasazení hřbetu s vysokou-hustotou listů-. Vysvětluje, co ve skutečnosti dělají vyrovnávací paměti přepínačů, proč je provoz AI a GPU zatěžuje odlišně, jak výběr vyrovnávací paměti ovlivňuje latenci a ztrátu paketů a co je třeba otestovat, než se pustíte do přechodu.
Co jsou přepínací vyrovnávací paměti?
Přepínací vyrovnávací paměť je dočasná paketová paměť. Když několik paketů potřebuje odejít přes stejný port ve stejném okamžiku, přepínač je nemůže přenést všechny najednou, takže zařazuje do fronty a přeposílá je, jakmile se výstupní port uvolní.
K tomuto řazení do fronty dochází během několika předvídatelných okamžiků:
- Mnoho{0}}k-jednomu (incast) provozu, kdy více odesílatelů cílí na stejného příjemce nebo uplink
- Microbursts, krátké a intenzivní špičky, které trvají mikrosekundy až několik milisekund
- Nesoulad rychlosti rozhraní, například port 400G napájející pomalejší downstream link
- Přetížené odkazy a synchronizované shluky přicházející z mnoha zdrojů najednou
- Zahlcení jedné konkrétní výstupní fronty nebo třídy provozu
Bez dostatečného množství použitelné vyrovnávací paměti přepínač zahazuje pakety. Při příliš velkém obsazení vyrovnávací paměti pakety sedí v řadě a latence stoupá. Dobrý návrh vyrovnávací paměti žije v napětí mezi těmito dvěma selháními: absorbuje skutečné dávky, aniž by se fronta změnila v zadržovací pero.
Proč provoz AI a GPU klade důraz na přepínání vyrovnávací paměti odlišně
Úlohy AI nevypadají jako webový nebo kancelářský provoz. Clustery GPU generují enormní východ-západní provoz mezi servery a během distribuovaného školení je komunikace často synchronizována: mnoho akcelerátorů si vyměňuje data ve stejný okamžik, stejným směrem a na stejné látce.
Kolektivní operace to zhoršují. Vše-snížený krok, synchronizace parametrů nebo výměna přechodu se může zhroutit do několika-k-jednoho nebo mnoha{4}}k-mnoha shluků, které během mikrosekund zablokují sadu výstupních front. Protože jsou výbuchy krátké a úzce korelované, lze je při hrubém monitorování snadno přehlédnout. Odkaz například dokáže přečíst pouze přibližně 40 % průměrného využití za jednu-sekundu nebo pět{10}}minutového okna dotazování, přičemž stále dosahuje řádkové rychlosti po dobu milisekund, což je dostatečně dlouhá doba na to, aby zaplnila frontu, označila ECN nebo vyvolala pauzu PFC.
Důvodem, proč na AI tkaninách tolik záleží, je struktura závislostí úlohy. Distribuovaný trénink má tendenci se pohybovat rychlostí svého nejpomalejšího toku. Když jeden uzel GPU čeká na zpožděný provoz, zbytek clusteru s ním často nepracuje a drahé akcelerátory spotřebovávají čas čekání v síti, místo aby pracovaly na počítači. Událost vyrovnávací paměti, která by byla na webové vrstvě neviditelná, zde může přímo prodloužit dobu dokončení úlohy.
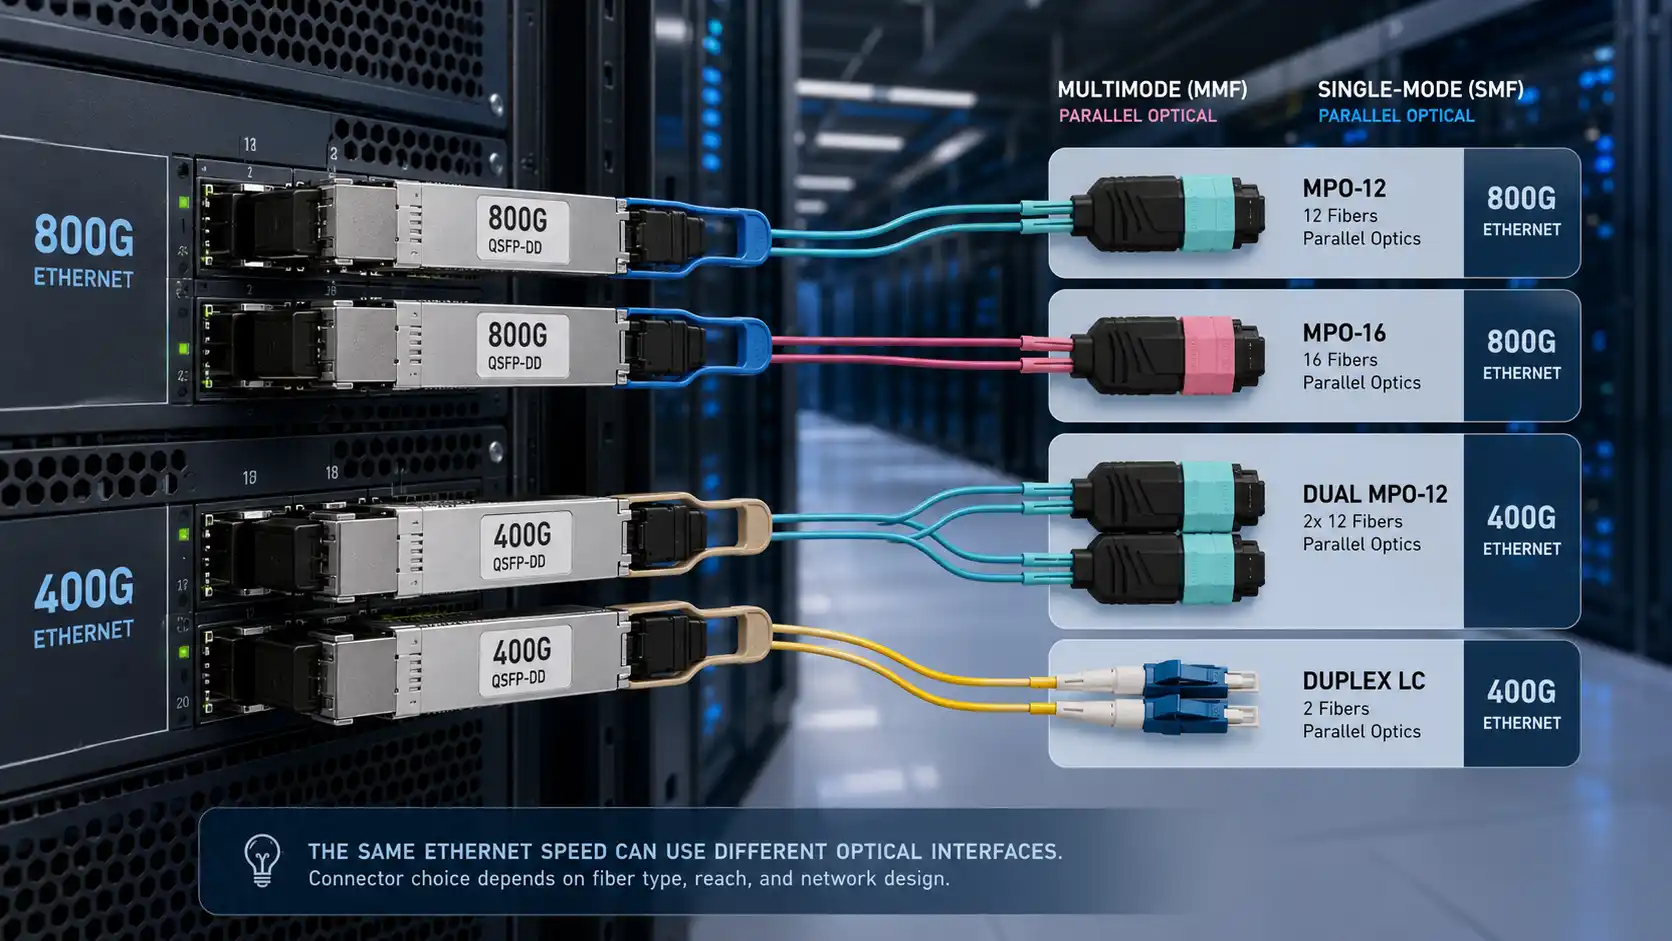
Tato východní-západní struktura je také důvodem, proč se spolu s chováním vyrovnávací paměti řídí i fyzická-vrstva. Backendy GPU s vysokou-hustotou jsou obvykle propojenyvysokohustotní MTP/MPO kabelážmezi křídlem a hřbetem a rychlost spojení se stále více nastavuje vámi zvolenou optikouModuly 400G a 800G, jako je QSFP-DD. Čím jsou tyto odkazy rychlejší a přetíženější, tím více práce musí vyrovnat vyrovnávací paměť přepínače a nastavení zahlcení během synchronizovaného shluku.

Jak přepínačové vyrovnávací paměti ovlivňují latenci, ztrátu paketů a propustnost
Tlumiče tvarují výkon třemi propojenými způsoby.
Příliš málo vyrovnávací paměti způsobuje ztrátu paketů
Když shluk překročí dostupnou vyrovnávací paměť, koncová část přepínače -zahodí pakety. V provozu založeném na protokolu TCP-, který spouští opakované přenosy a snižuje efektivní propustnost. V úložišti a provozu AI to může navýšit dobu dokončení úlohy a způsobit nestálost výkonu. Past je v tom, že průměrná šířka pásma často vypadá dobře: při incastové události se několik odesílatelů dostane do stejné výstupní fronty téměř ve stejný okamžik a fronta přeteče, i když graf minuta{5}}po-minutě vypadá klidně.
Příliš mnoho provozu ve frontě zvyšuje latenci
Velká vyrovnávací paměť není bezplatnou bezpečnostní rezervou. Pokud pakety leží v hluboké frontě, hromadí se zpoždění ve frontě a síť se do ní zasunebufferbloat, kde jsou poklesy vzácné, ale latence je vysoká a nepředvídatelná. Tento režim selhání bylpodrobně zdokumentováno Gettysem a Nicholsem v ACM Queuea je to přesně špatný výsledek pro backendy GPU citlivé na latenci-, kde je předvídatelná nízká latence důležitější než skrytí přetížení v paměti.
Špatná alokace vyrovnávací paměti vytváří nespravedlnost
Celková velikost vyrovnávací paměti skrývá důležitější otázku: jak přepínač rozděluje paměť mezi porty, fronty a třídy provozu. Přepínač může přenášet spoustu agregované vyrovnávací paměti a přesto se chovat špatně, pokud jeden port nebo třída vyčerpá sdílený fond a zbytek vyhladoví. V prostředí AI a úložiště tato nespravedlnost zpomaluje celou úlohu, protože nejpomalejší tok určuje čas dokončení.

Shared Buffer vs Dedicated Buffer vs Deep Buffer
Když porovnáte přepínače datového centra, architektura vyrovnávací paměti je důležitější než číslo hlavní kapacity.
Sdílená vyrovnávací paměť
Sdílená vyrovnávací paměť je společný paměťový fond, ze kterého čerpají porty a fronty na vyžádání. Protože nevyužitou paměť v tiché oblasti lze zapůjčit všude tam, kde dojde k přetížení, sdílené vyrovnávací paměti dobře absorbují shluky v datových centrech, kde port, který je v jednu chvíli nečinný, může v další chvíli vybuchnout. Jejich slabinou je, že spoléhají na dobrou alokační logiku, aby zabránili jedné horké frontě sníst bazén.
Vyhrazený buffer
Vyhrazená vyrovnávací paměť je vyhrazena pro konkrétní port, frontu nebo třídu provozu. Zlepšuje izolaci, protože jedna přetížená třída je méně schopná spotřebovat vše, ale přílišné{1}}rezervování plýtvá kapacitou, protože paměť zamčená na tichý port není k dispozici tam, kde skutečně dojde k výbuchu.
Hluboký buffer
Přepínač hluboké{0}}vyrovnávací paměti přenáší mnohem větší vyrovnávací paměť, která je navržena pro velké dávky,-vzdálená spojení nebo trvalé nesoulady rychlosti. Hluboké vyrovnávací paměti si vydobyjí své místo v některých rolích WAN, směrování a agregace, často ve spojení sjedno{0}}vlákno pro delší-vzdálenost, ale často jsou nesprávným výchozím nastavením pro backend GPU s nízkou{0}}latencí, kde mají tendenci maskovat přetížení a přidávat zpoždění. U tkanin citlivých na latenci-předvídatelné přeposílání obvykle překonává nezpracovanou hloubku vyrovnávací paměti.
Rychlé srovnání
| Typ vyrovnávací paměti | Pevnost | Hlavní riziko | Nejlépe sedí |
|---|---|---|---|
| Sdíleno | Flexibilní absorpce prasknutí | Vyžaduje pevnou alokační logiku | Dynamický provoz datového centra |
| Věnováno | Silná izolace mezi třídami | Nevyužitá kapacita, pokud je rezervována nad{0}} | Třídy provozu, které musí být chráněny |
| Hluboký | Absorbuje velmi velké dávky | Vyšší latence ve frontě | WAN, směrování, speciální agregace |
Přepínací vyrovnávací paměti a RoCEv2 Congestion Control: ECN a PFC
Většina AI Ethernetových zařízení používá RoCEv2 pro nízkou-latenci a vysokou{2}}propustnost RDMA. V těchto sítích jsou vyrovnávací paměti a řízení zahlcení neoddělitelné: prahové hodnoty vyrovnávací paměti, které nastavíte, určují, kdy se označí ECN a kdy se spustí PFC.
ECN by měla signalizovat přetížení brzy
Explicitní oznámení o přetížení (ECN), definované v RFC 3168, umožňuje přepínači označit pakety jako přetížení namísto jejich zahození. Přijímač ozvěnou tento signál zpět, takže odesílatel zpomalí, než se fronta přeteče. V tkaninách RoCEv2 je práh označování rozhodnutím ladění se skutečnými důsledky: označte příliš pozdě a fronta je již hluboká, když zdroje reagují; značka příliš brzy a snížíte propustnost, nemusíte se vzdát.
PFC by měla být záchranná síť, nikoli první reakce
Prioritní-řízení toku (PFC), standardizované jako IEEE 802.1Qbb, pozastaví provoz na prioritní třídě, aby se zabránilo ztrátě na bezztrátových frontách. Je to nezbytné, ale je to neomalený nástroj. Příliš často se o ni opírejte a šíří se zácpy proti proudu, vytvářejí pauzy a blokování-hlavní{3}}čáry, které trestá toky, které nikdy nebyly příčinou. Zdravější vzorec je dobře zaveden: inRozsáhlá práce společnosti Microsoft-RDMA, která zavedla DCQCNŘízení přetížení založené na rychlosti{0}} řízené ECN zpracovává rutinní události, zatímco PFC zůstává v záloze jako poslední obranná linie, a tento dokument také poskytuje konkrétní pokyny pro ladění prahů vyrovnávací paměti přepínačů.
Mezní hodnoty vyrovnávací paměti musí odpovídat pracovní zátěži
Mezní hodnoty zkopírované z referenčního návrhu jen zřídka přežijí kontakt se skutečným provozem. Školení AI, inference, úložiště a smíšené cloudové zátěže se shlukují různě a správná nastavení ECN/PFC závisí na shluku, rychlosti připojení, poměru nadměrného odběru, návrhu fronty a na tom, jak moc zátěž toleruje latenci oproti ztrátě. Zacházejte s výchozím nastavením dodavatele jako s výchozím bodem a poté nalaďte na svůj vlastní provoz.
Diagnostická vyrovnávací paměť-Související problémy: Příznaky, příčiny a metriky
Když výkon aplikace klesne, ale řídicí panely vypadají zeleně, tlak vyrovnávací paměti je běžnou skrytou příčinou. Užitečným prvním krokem je číst telemetrii v pořadí příčiny a následku spíše než zírat na využití spojení. Níže uvedená tabulka mapuje příznaky na pravděpodobné problémy s vyrovnávací pamětí a metriku, která je potvrzuje.
| Příznak | Pravděpodobná příčina-vyrovnávací paměti | Nejprve zkontrolujte metriku |
|---|---|---|
| Retransmise s normálním průměrným využitím | Microburst tail klesne na výstupní frontu | Obsazenost fronty vrcholí, ocas a výstup klesá |
| Špičky latence s několika nebo žádnými kapkami | Příliš{0}}hluboká fronta / vyrovnávací paměť | Percentily latence (p99), hloubka fronty |
| Propustnost se zhroutí z mnoha-do{1}}jednoho | Incast přetékající sdílený bazén | Poklesy během incastu, podle-obsazenosti fronty |
| Periodické zastavení napříč shlukem | PFC pozastavuje šíření bouří proti proudu | Snímky pauzy PFC a trvání pauzy |
| Jeden pomalý tok vleče celou práci | Nespravedlivé sdílení vyrovnávací paměti mezi třídami | Podle-prioritní obsazenosti, horké{1}}počítače front |
| GPU nečinně čekají v síti | Přetížení rozšiřující kolektivní operace | Rychlost značek ECN, čas dokončení toku, využití GPU |
Čtěte shora dolů, přirozeným diagnostickým řetězcem je hloubka fronty, pak značky ECN, pak poklesy ocasu, pak snímky pauzy PFC, pak čas dokončení toku a pak využití GPU. Pokud jsou síťové metriky čisté, ale úlohy jsou stále pomalé, je problém pravděpodobně spíše v předřazené látce než ve vyrovnávací paměti přepínače.
Laboratorní testy, které stojí za to spustit, a jak vypadá „úspěch“.
Před nasazením do AI nebo vysoce{0}}výkonné struktury otestujte provoz, který se podobá vašemu skutečnému pracovnímu vytížení, a pro každý test definujte kritérium úspěšnosti, nikoli jen sledování rychlosti linky.
- Mnoho{0}}na-jednoho incast:zvýšit poměr ventilátoru-; Pass znamená žádné poklesy a omezenou latenci p99 při vašem cílovém nadměrném odběru.
- Mnoho{0}}k-mnoha, všichni-omezují styl:řídit synchronizované dávky; pass znamená spravedlivé časy dokončení napříč toky bez jediného opozdilce.
- Smíšený krátký- a dlouhý-tok:běžet slon a myš teče společně; průchod znamená, že krátké toky udržují nízkou latenci, zatímco dlouhé toky stále naplňují odkaz.
- Přetížení RoCEv2 s ověřením ECN/PFC:potvrďte ECN značky před PFC pauzami; pass znamená, že ECN dělá práci a PFC se spouští jen zřídka.
- Překročení odběru a opětovné sblížení selhání:pustit odkaz uprostřed-série; pass znamená půvabné přesměrování bez poklesu nebo latence.
Cílem není dokazovat-propustnost linek na nečinném přepínači. Je to vidět, jak se přepínač chová, když je provoz přerušovaný, synchronizovaný a nespravedlivý, což je jediný stav, na kterém ve výrobě záleží. Když plánujete kabeláž a konektory pro podporu těchto testů v měřítku, aninženýrské srovnání možností MTP a MPOje užitečným společníkem.
Hluboká{0}}vyrovnávací paměť nebo nízká{1}}přepínač latence?
Neexistuje jediný nejlepší vypínač, pouze ten, který se nejlépe hodí pro danou látku. Použijte níže uvedenou tabulku k rychlému zúžení výběru a poté jej ověřte pomocí výše uvedených laboratorních testů.
| Pokud je vaše látka | Upřednostnit | Naklánění vyrovnávací paměti |
|---|---|---|
| Backend AI GPU (synchronizované shluky, latence-kritická) | Nízká latence, silná telemetrie, ladění ECN/PFC | Nízká-latence, sdílená s dobrou alokací |
| Skladování / bezztrátové | Spravedlnost, doba dokončení úlohy, latence při zátěži | Střední, s dobře{0}}izolovanými třídami |
| Smíšený cloud (různé rychlosti připojení) | Flexibilní alokace, izolace tříd, viditelnost | Sdílené a flexibilní |
| agregace WAN / dlouhé-vzdálenosti | Absorbuje velké dávky a nesoulad rychlosti | Hluboká vyrovnávací paměť (stále kontrolována proti cílům latence) |
Smíšené cloudové struktury jsou nejobtížnějším případem, protože často kombinují vyšší{0}}rychlostní uplinky s pomalejším přístupem. Pokud mapujete tyto přístupové rychlosti, průvodceRozhraní 10GBASE-T a SFP+ 10GbEvám může pomoci naplánovat, kam dopadnou přechody rychlosti, a tedy i vyrovnávací tlak.
FAQ
Otázka: Jsou větší vyrovnávací paměti přepínačů vždy lepší?
Odpověď: Ne. Větší vyrovnávací paměti snižují poklesy paketů během shluků, ale také nechávají pakety ve frontě déle, což zvyšuje latenci a může způsobit naplnění vyrovnávací paměti. U AI a úložišť citlivých na latenci-střední, dobře{3}}spravovaná vyrovnávací paměť obvykle překonává velmi hlubokou vyrovnávací paměť. Nejlepší vyrovnávací paměť je ta, která má velikost a je přidělena tak, aby absorbovala vaše skutečné dávky bez přidání zbytečného zpoždění.
Otázka: Jaký je rozdíl mezi sdílenou vyrovnávací pamětí a vyhrazenou vyrovnávací pamětí?
Odpověď: Sdílená vyrovnávací paměť je společný fond, ze kterého může čerpat jakýkoli port nebo fronta, když to potřebuje, což umožňuje efektivně absorbovat nepředvídatelné shluky. Vyhrazená vyrovnávací paměť je vyhrazena pro konkrétní port, frontu nebo třídu, což zlepšuje izolaci, ale může plýtvat pamětí, pokud je rezervovaný prostor nečinný. Mnoho přepínačů datových center používá hybrid obou.
Otázka: Proč mikrobursty způsobují ztrátu paketů, i když se využití zdá nízké?
Odpověď: Standardní monitorování průměruje provoz během sekund nebo minut, takže vyhlazuje špičky. Microburst může zasáhnout linkovou rychlost pouze na několik milisekund, zaplnit výstupní frontu a způsobit pokles ocasu, zatímco zprůměrovaný graf stále ukazuje odkaz jako lehce nabitý. K zobrazení těchto událostí potřebujete frontu a telemetrii v milisekundách-.
Otázka: Potřebují datová centra AI hluboké{0}}přepínače vyrovnávací paměti?
Odpověď: Obvykle ne na backendu GPU. Hluboké vyrovnávací paměti mají tendenci maskovat přetížení a zvyšovat latenci, což funguje proti předvídatelnému předávání s nízkou{1}}latencí, které distribuované školení potřebuje. Hluboké vyrovnávací paměti jsou vhodnější pro role WAN, směrování nebo agregace. U clusterů AI je telemetrie, spravedlivé přidělování a dobře{4}}vyladěné ECN/PFC obvykle důležitější než hrubá hloubka vyrovnávací paměti.
Otázka: Jak ovlivňují vyrovnávací paměti přepínačů výkon RoCEv2?
Odpověď: V RoCEv2 rozhodují prahové hodnoty vyrovnávací paměti, kdy ECN označí pakety a kdy PFC pozastaví prioritu. Nastavení dobře, ECN zpomaluje odesílatele včas a udržuje fronty mělké; špatně nastavené, přetečení front nebo PFC se spouští příliš často a šíří zahlcení. Vyladění prahů vyrovnávací paměti podle pracovní zátěže je jedním z nejdůležitějších kroků k dosažení dobrého chování RoCEv2.
Otázka: Jaké metriky vyrovnávací paměti bych měl sledovat v produkci?
Odpověď: Sledujte obsazenost fronty, poklesy koncové části a výstupu, rychlost značek ECN a snímky a trvání pozastavení PFC a poté je připojte k signálům aplikace, jako je čas dokončení toku a v případě AI tkanin využití GPU. Pokud je výkon aplikace slabý, zatímco průměrné využití spojení vypadá normálně, je pravděpodobně podezřelý skrytý tlak vyrovnávací paměti a mikrobursty.
Klíčové věci
Vyrovnávací paměti přepínačů hrají rozhodující roli ve výkonu sítě AI a datových center, ale samotná kapacita vám neřekne, zda je přepínač správnou volbou. Dobrý návrh vyrovnávací paměti pohlcuje realistické shluky, omezuje ztráty paketů, udržuje předvídatelnou latenci, podporuje signalizaci ECN a PFC a poskytuje dostatek telemetrie k řešení problémů. U datových center s umělou inteligencí vyhodnoťte architekturu vyrovnávací paměti společně s řízením přetížení, vyvažováním zátěže, správou front a chováním vaší skutečné pracovní zátěže, nikoli jako izolované číslo na listu se specifikacemi.
Před potvrzením otestujte přepínač za podmínek incast, microburst a přetížení a sledujte, jak sdílí paměť, když se provoz stane nespravedlivým. Nejlepší buffer není ten největší. Je to architektura, která udržuje vaše aplikace rychlé, spravedlivé a předvídatelné v reálném provozu.